robots.txt и sitemap.xml: как настроить и проверить файлы сайта
Два небольших текстовых файла — robots.txt и sitemap.xml — решают, какие страницы вашего сайта поисковый робот увидит и в каком порядке до них доберётся. Ошибка в одной строке robots.txt может закрыть от Google весь сайт, а правильная карта сайта помогает быстрее находить новые страницы. В этой статье — что делает каждый файл, как они выглядят, что закрывать, что отдавать в карту, как подключить и проверить. Эти файлы стоит проверять в начале SEO-аудита и перед запуском нового сайта: это занимает минут десять и нередко находит ошибки, о которых никто не подозревал.
Что такое robots.txt и sitemap.xml простыми словами
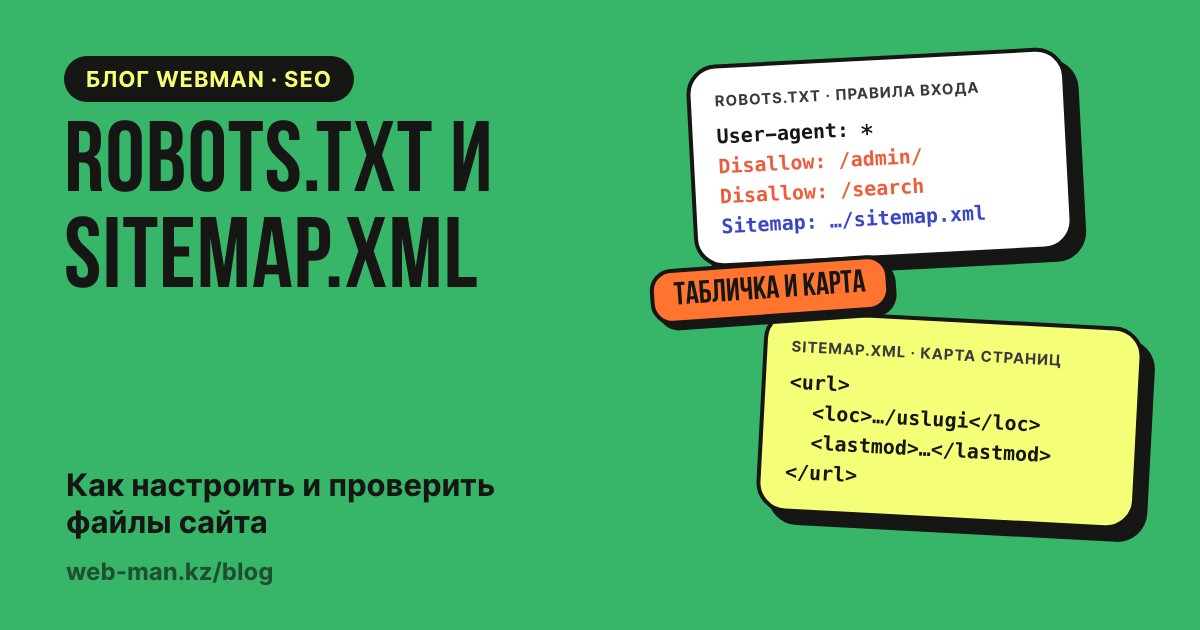
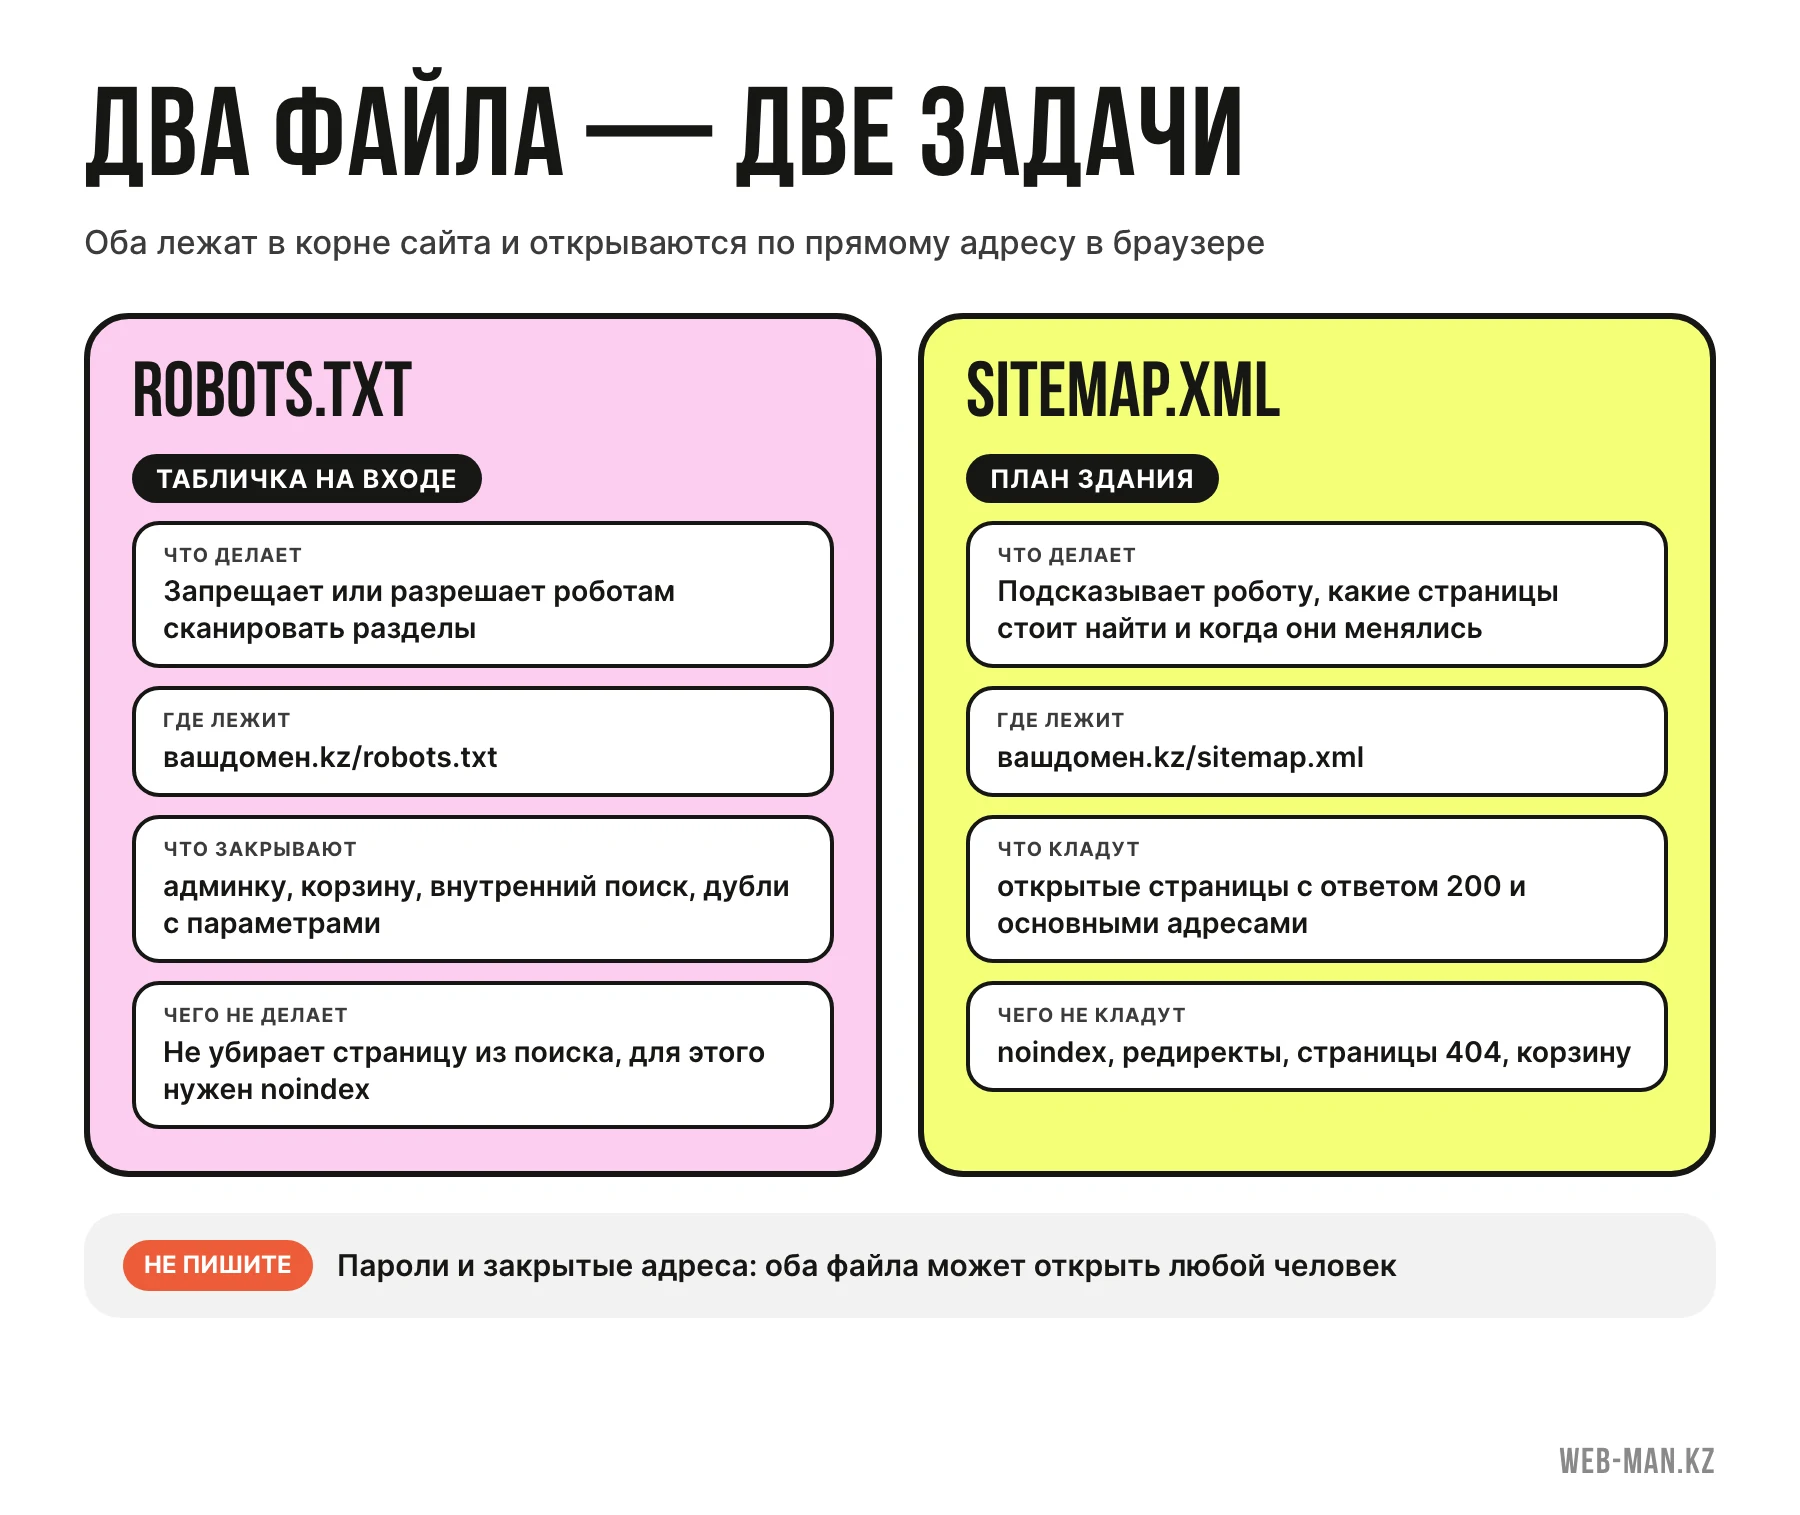
Представьте офисное здание. robots.txt — табличка на входе: «в эту дверь не заходить, там склад». sitemap.xml — план здания, который вы сами протягиваете гостю: «вот все комнаты, которые стоит посмотреть». Один файл ограничивает, другой подсказывает. Они дополняют друг друга, но заменить друг друга не могут.
Оба файла лежат в корне сайта и открываются по прямому адресу: `вашдомен.kz/robots.txt` и `вашдомен.kz/sitemap.xml`. Если открыть их в браузере, вы увидите обычный текст и список адресов. Поэтому и то и другое публично: ничего секретного в них класть нельзя.
Как устроен файл robots.txt
Файл состоит из блоков правил. В каждом блоке указано, для какого робота правило, и что ему запрещено или разрешено.
Вот типичный простой пример для небольшого сайта:
- `User-agent: *` — правило для всех роботов.
- `Disallow: /admin/` — не сканировать раздел администратора.
- `Disallow: /search` — не сканировать внутренний поиск по сайту.
- `Allow: /admin/public/` — исключение: эту папку внутри закрытого раздела можно.
- `Sitemap: https://вашдомен.kz/sitemap.xml` — адрес карты сайта.
Что нужно знать про синтаксис:
- Путь пишется от корня и начинается со слэша: `/admin/`.
- Звёздочка `` означает любые символы, знак `$` — конец адреса. Например, `Disallow: /?sort=` закроет адреса с параметром сортировки. Google эти символы поддерживает.
- Пустой Disallow (`Disallow:` без пути) ничего не закрывает.
- Одна строка `Disallow: /` закрывает от сканирования весь сайт. Это самая опасная строка в файле.
- Регистр важен в путях: `/Admin/` и `/admin/` — разные адреса.
- Файл лежит только в корне домена. Для поддомена (например, shop.вашдомен.kz) нужен свой robots.txt.
Директивой `Sitemap` можно указать адрес карты прямо в файле: роботы найдут её без вашей помощи.
Что закрывать в robots.txt, а что нельзя
Закрывать стоит то, что бесполезно для поиска и тратит время робота.
Что обычно закрывают
- Служебные разделы: панель администратора, технические папки. Для WordPress, например, закрывают `/wp-admin/`, но оставляют доступным `admin-ajax.php`, который нужен для работы страниц.
- Корзину, оформление заказа, личный кабинет. В поиске они не нужны.
- Внутренний поиск по сайту и страницы с бесконечными вариантами выдачи.
- Адреса с параметрами, которые создают дубли: сортировки, фильтры, метки отслеживания. Для дублей лучше работает тег canonical, но robots.txt помогает не тратить на них ресурсы сканирования.
Что закрывать нельзя
- Важные страницы услуг, товаров, статей.
- Файлы стилей и скриптов (CSS и JavaScript). Google открывает страницу как браузер. Если закрыть стили, он увидит страницу без оформления и хуже поймёт, как она выглядит на телефоне.
- Картинки, которые должны находиться в поиске по картинкам.
Главная ловушка: robots.txt не убирает страницы из Google
Запрет в robots.txt — это запрет на сканирование, а не на индексирование. Если на закрытую страницу ведут ссылки с других сайтов, Google может показать её адрес в результатах поиска, хотя содержимое прочитать не смог. Если нужно, чтобы страницы не попадали в поиск, используйте метатег `noindex`, причём страница должна быть открыта для сканирования: иначе робот не увидит сам тег. Для действительно конфиденциальных данных нужен пароль, а не robots.txt. Эту путаницу мы разбирали и в статье «Почему сайт не индексируется в Google».
Примеры правил для двух типов сайтов
Это ориентиры, а не готовые файлы: пути на вашем сайте могут отличаться, и перед внедрением их нужно проверить.
Сайт услуг или визитка
Закрывать почти нечего: служебные разделы, если они есть, и страницы благодарности за заявку (чтобы случайные заходы на них не искажали статистику). Остальное открыто, в конце — строка `Sitemap:`.
Интернет-магазин
Здесь правил больше, потому что магазин порождает много технических адресов:
- корзина и оформление заказа;
- личный кабинет и сравнение товаров;
- внутренний поиск;
- адреса с параметрами сортировки и фильтров, которые создают бесконечные варианты одного списка товаров.
Важно не закрыть лишнего: полезные страницы фильтров, которые люди ищут (например, «кроссовки мужские 42 размера»), могут приносить трафик, и тогда их, наоборот, стоит оформить как отдельные страницы. Подробнее о структуре магазина — на странице интернет-магазина.
Что делать с роботами нейросетей
Сегодня сайты читают не только поисковые роботы Google, но и роботы нейросетей. У каждого из них своё имя (User-agent), и для них можно задать отдельный блок правил в robots.txt. Это решение владельца сайта: закрыв доступ, вы защищаете материалы от использования, но можете реже попадать в ответы нейросетей. Универсального ответа нет, подумайте, что важнее для вашего бизнеса, и принимайте решение осознанно. О том, как попадать в ответы нейросетей, подробнее на странице GEO-продвижения.
Что должно быть в sitemap.xml
Карта сайта — список адресов, которые вы хотите видеть в поиске. Для каждого можно указать дату последнего изменения (`lastmod`). Google использует её, если даты честные: меняли страницу — обновили дату, не меняли — оставили.
Что включать
- Только страницы, которые должны быть в поиске: услуги, категории, товары, статьи, контакты.
- Только основные (канонические) адреса, без дублей.
- Только страницы с кодом ответа 200.
Чего в карте быть не должно
- Страницы с `noindex`.
- Адреса, которые перенаправляют на другие (редиректы 301 и 302).
- Несуществующие страницы (ошибка 404).
- Закрытые в robots.txt адреса: это противоречие, которое Search Console покажет как ошибку.
- Служебные страницы вроде корзины и результатов поиска.
Лишние теги `priority` и `changefreq` можно не заполнять: Google их игнорирует. Если страниц очень много, помните о лимите: один файл карты может содержать не более 50 000 адресов или весить не более 50 МБ в разжатом виде. Для больших сайтов делают несколько карт и общий индексный файл.
Где найти файлы на Tilda, WordPress и своём сайте
Эта часть зависит от платформы, а интерфейсы меняются, поэтому проверяйте результат по прямому адресу в браузере.
- Tilda. Карта сайта обычно формируется автоматически и доступна по адресу `вашдомен.kz/sitemap.xml`, а правила для роботов задаются в настройках сайта в разделе SEO. Проверьте оба адреса после подключения домена.
- WordPress. Начиная с версии 5.5 система сама создаёт карту (обычно по адресу `/wp-sitemap.xml`). SEO-плагины создают свою, чаще всего с адресом `/sitemap_index.xml` или `/sitemap.xml`. Следите, чтобы активной была одна карта, а не две.
- Сайт на заказ. Файлы создаются разработчиком. Попросите, чтобы карта обновлялась автоматически при добавлении страниц, а robots.txt отличался на тестовой и боевой версиях, и включите эти пункты в приёмку: как её проводить, описано в статье «Как принять сайт у разработчика». Если сайт только планируется, посмотрите нашу разработку сайтов.
Отдельно про переезды: если сайт на тестовом адресе закрыт строкой `Disallow: /`, при переносе на боевой домен её легко забыть. О том, как не потерять позиции при переезде, читайте в статье «Переезд сайта без потери позиций».
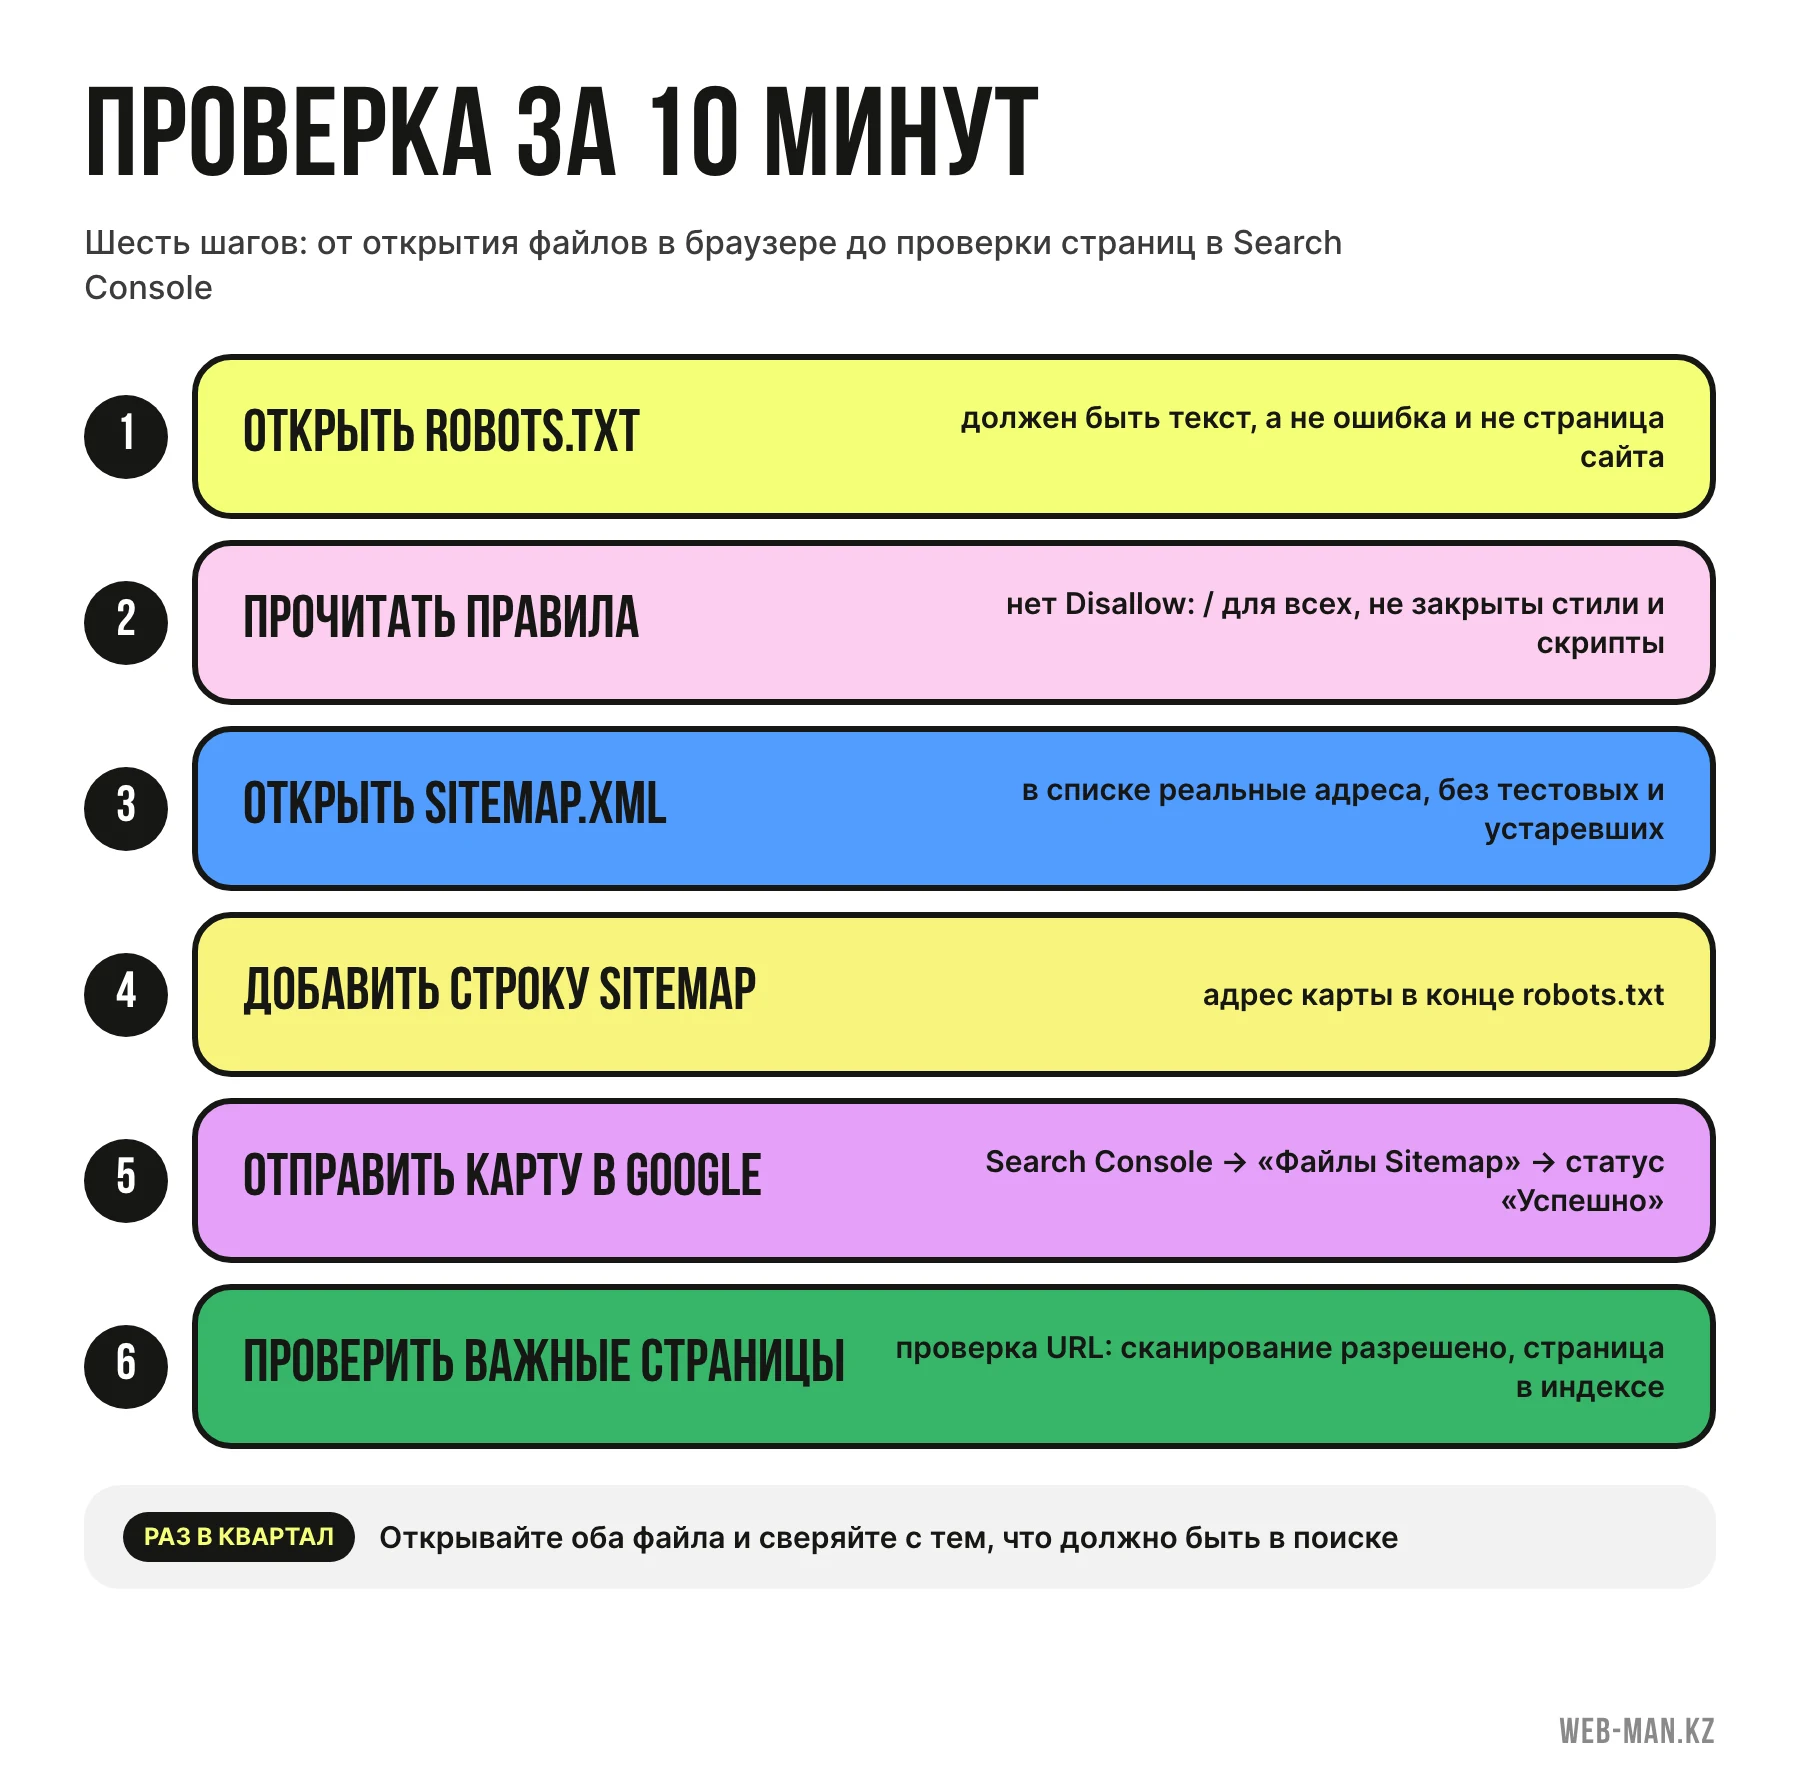
Как подключить и проверить: 6 шагов
- Откройте `вашдомен.kz/robots.txt` в браузере. Файл должен открываться как текст, а не выдавать ошибку или страницу сайта.
- Прочитайте правила построчно. Нет ли строки `Disallow: /` для всех роботов и не закрыты ли папки со стилями и скриптами.
- Откройте `вашдомен.kz/sitemap.xml`. Там должен быть список реальных адресов вашего сайта, без тестовых и устаревших.
- Добавьте строку `Sitemap:` с адресом карты в robots.txt.
- Отправьте карту в Google Search Console: раздел «Файлы Sitemap» → введите адрес → «Отправить». Через время статус станет «Успешно», а рядом появится число найденных страниц. Как работать с этим сервисом, описано в статье «Google Search Console: как пользоваться».
- Проверьте важные страницы инструментом проверки URL в Search Console: он покажет, разрешено ли сканирование и проиндексирована ли страница. Состояние файла robots.txt видно в настройках сервиса, в отчёте о файле.
Чек-лист: проверьте свои файлы
- Файл robots.txt открывается по адресу в корне сайта.
- В нём нет `Disallow: /` для всех роботов (кроме тестового сайта).
- Не закрыты важные страницы, стили и скрипты.
- Закрыты служебные разделы, корзина, внутренний поиск.
- В robots.txt указан адрес карты сайта.
- Файл sitemap.xml открывается и содержит актуальные адреса.
- В карте нет страниц с noindex, редиректов и ошибок 404.
- Карта подключена в Search Console, статус «Успешно».
- После добавления новых страниц карта обновляется сама.
- Раз в квартал вы открываете оба файла и сверяете с тем, что должно быть в поиске.
Типичные ошибки
- Забытая строка `Disallow: /` со времён разработки. Сайт запущен, а Google его не сканирует.
- Закрытые CSS и JavaScript.
- Попытка убрать страницу из поиска через robots.txt, вместо noindex или удаления страницы.
- Тестовые адреса в карте после переезда.
- Две разные карты от CMS и от плагина с разным содержимым.
- Карта с адресами, которые ведут на редиректы.
- Ошибка сервера при открытии robots.txt. Если файл отдаёт ошибку 5xx, робот может приостановить сканирование сайта. Ответ 404 означает «ограничений нет».
Итог
- robots.txt управляет сканированием, sitemap.xml подсказывает, что индексировать.
- Строка `Disallow: /` закрывает весь сайт: проверяйте её после запуска и переезда.
- Чтобы убрать страницу из поиска, нужен noindex, а не robots.txt.
- В карту сайта попадают только открытые, канонические страницы с ответом 200.
- Подключите карту в Search Console и открывайте файлы хотя бы раз в квартал.
Если вы хотите, чтобы мы проверили технические файлы и состояние индексации вашего сайта, посмотрите нашу услугу SEO-продвижения или напишите через страницу контактов: разберём сайт и скажем, что исправить в первую очередь.


